Los datos mutan cada segundo — el valor está en captar esa mutación de forma fiable y accionable.
Por qué el CDC importa en las arquitecturas Lakehouse
Change Data Capture (CDC) dejó de ser una técnica de bastidor para convertirse en pieza central de las plataformas analíticas modernas. En una era en la que decisiones operacionales e informes estratégicos exigen frescura de datos, pasar de cargas batch diarias a la captura de cambios en tiempo casi real transforma procesos: detección de fraude, actualización de inventario, métricas de experiencia del usuario e informes financieros con latencia reducida.
En el contexto de Microsoft Fabric, donde la Lakehouse y el OneLake funcionan como fuente única de la verdad para BI e IA, integrar CDC correctamente garantiza que los modelos de datos en Power BI y las canalizaciones de Machine Learning tengan inputs consistentes. El desafío no es solo mover eventos; es preservar el orden, garantizar idempotencia, gestionar la evolución de esquema y minimizar costes operativos — todo ello sin sacrificar los SLA de latencia e integridad.
Además de los beneficios obvios de frescura de datos, una canalización CDC bien diseñada reduce costes indirectos: menos retrabajos en informes, menos consultas de reconciliación manual y decisiones de negocio tomadas con confianza. En organizaciones medianas, frecuentemente se consigue reducir ciclos de decisión de horas a minutos y recortar un 10–30% el esfuerzo humano asociado a correcciones de datos.
Opciones de ingestión: streaming vs micro-batch en Fabric
La primera decisión práctica es el patrón de ingestión. El micro-batch (por ejemplo, consultas incrementales vía Azure Data Factory/Power Query en una cadencia de 1–5 minutos) es sencillo de implementar y suficiente para muchos escenarios analíticos con latencia tolerante. En contraste, streaming (Debezium/Kafka/Event Hubs → Spark Structured Streaming en Fabric) está indicado cuando se exige latencia subminuto y procesamiento por evento — por ejemplo, medios de pago, detección de anomalías en tiempo real o actualización instantánea de inventario durante campañas.
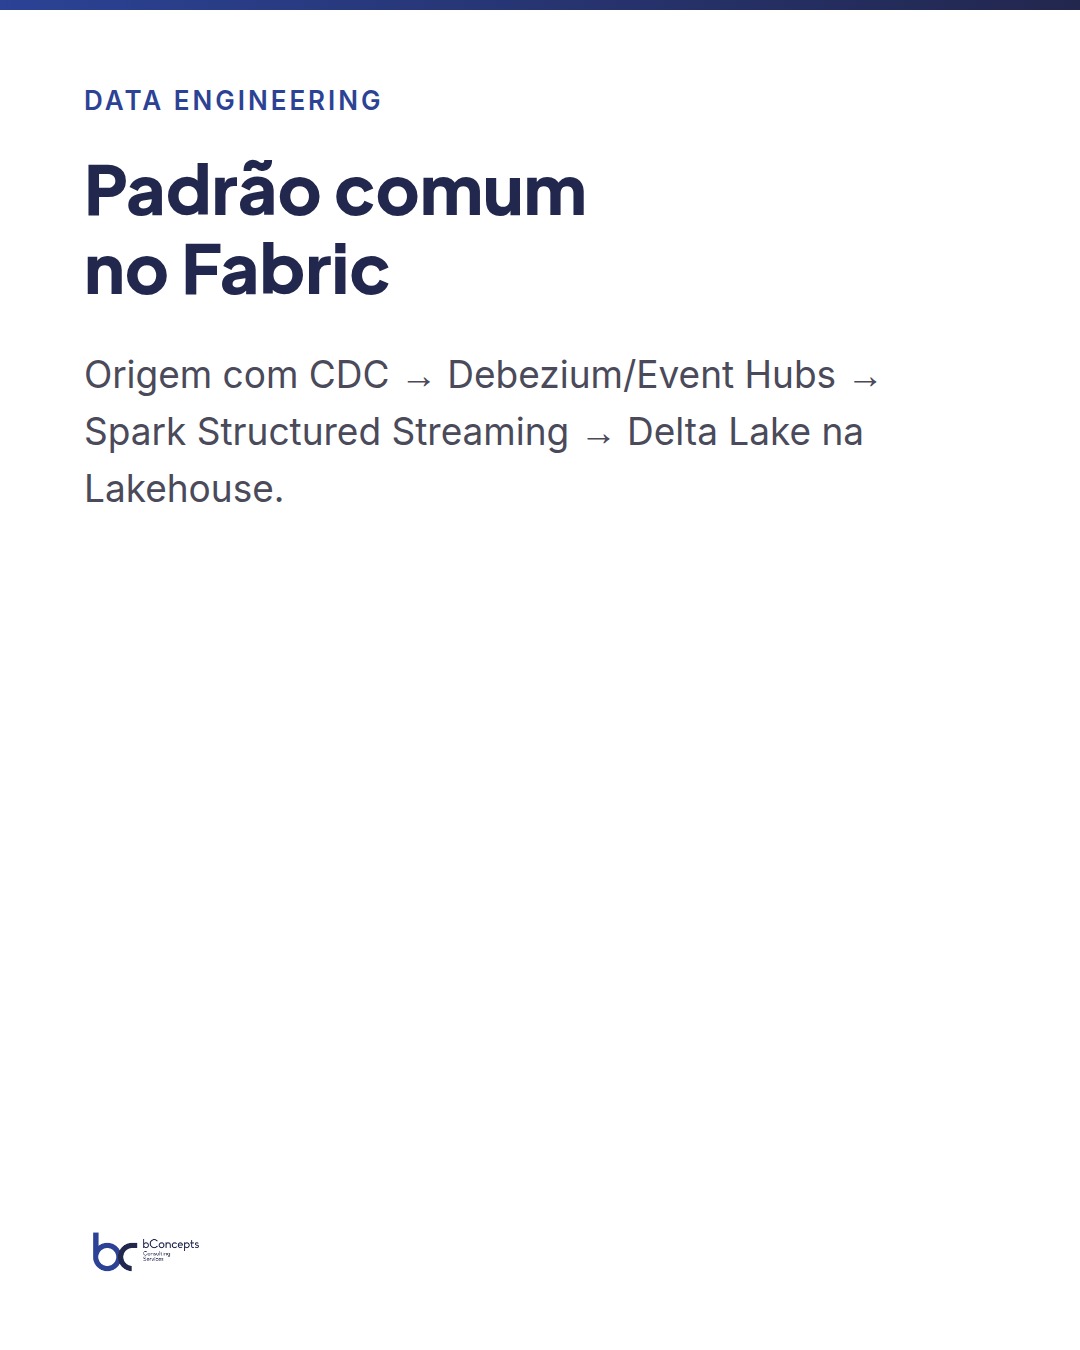
En Fabric, un patrón común es: origen con soporte CDC (SQL Server, PostgreSQL, Cosmos DB), productor CDC (Debezium o protocolo nativo), transporte (Apache Kafka o Azure Event Hubs) y consumidor Spark Structured Streaming que escribe en Delta Lake en la Lakehouse. Para escenarios más simples, canalizaciones de micro-batch con watermarking y consultas incrementales reducen complejidad y costes y aún consiguen latencias del orden de 1–5 minutos.
Algunas reglas prácticas para decidir: si el negocio exige una latencia media inferior a 1 minuto y picos previsibles hasta decenas de miles de eventos por segundo, opte por streaming. Si la latencia aceptable es de 1–15 minutos y el equipo prefiere simplicidad operacional, el micro-batch es frecuentemente la elección correcta. También existe un punto intermedio: micro-batches de 30–60 segundos que ofrecen una buena relación entre latencia y coste operacional.
Idempotencia, ordenación y resolución de conflictos
En un mundo de reintentos, duplicados y latencia variable, diseñar canalizaciones idempotentes es obligatorio. Estrategias prácticas incluyen la utilización de claves naturales o surrogate keys, un campo de secuencia/LSN (Log Sequence Number) y un timestamp de cambio. Al escribir en tablas Delta, el patrón "merge by key using sequence" permite aplicar solo el cambio más reciente, descartando duplicados o reordenaciones.
Un esquema común de evento CDC contiene: pk, op_type (I/U/D), change_ts, lsn, payload y posiblemente un campo is_tombstone. El consumidor ejecuta un MERGE por pk con condición de actualización solo cuando lsn o change_ts sea mayor que el actualmente persistido. Ejemplo lógico de condición: WHEN MATCHED AND incoming.lsn > target.lsn THEN UPDATE SET ...
Para gestionar reordenaciones, mantenga ventanas de tolerancia (por ejemplo, 15 minutos) durante las cuales se aceptan eventos tardíos para actualizar registros, y registros que llegan fuera de esa ventana van a una tabla de "late arrivals" para reconciliación manual o automática. En sistemas con tolerancia cero a inconsistencias temporales — por ejemplo, conteo de inventario sincronizado con POS — consideren mecanismos adicionales como confirmación de lectura en el productor o versiones por transacción.
El tratamiento de deletes merece atención: no suponga que un delete en el origen significa eliminar inmediatamente el registro en la Lakehouse. En lugar de eso, use tombstones (is_deleted=TRUE, change_ts) y políticas de retención/expurgo, lo que permite auditar y reconciliar antes de efectuar un VACUUM definitivo.
Gestionar la evolución de esquema en canalizaciones CDC
La evolución de esquema es la principal fuente de rupturas en canalizaciones CDC. Añadir columnas, cambiar tipos o renombrar campos puede romper consumidores aguas arriba e informes aguas abajo. Existen dos grandes tácticas: permisiva y explícita. La permisiva usa formatos autodescriptivos (AVRO/JSON con schema registry) y operaciones de escritura que soportan schema-on-read/merge; la explícita introduce versiones de esquema y contratos claros entre product owners y equipos de datos.
Prácticas concretas que reducen riesgo: 1) obligar compatibilidad de esquema en el registry (backwards/forwards/fully compatible según el caso); 2) usar nuevos campos como opcionales y con valores por defecto; 3) evitar renombramientos directos — en lugar de eso, introduzca la nueva columna simultáneamente a la antigua y planifique la eliminación tras un período de coexistencia (por ejemplo, 90 días).
En Fabric, emplear un schema registry (Confluent o Azure Schema Registry) y garantizar que la escritura en Delta implique schema merging controlado es pragmático. Para pruebas, automaticen escenarios en staging: cambiar tipo de columna integer->bigint, añadir arrays/structs y validar consumidores. Siempre incluyan backfills cuando una columna pasa a ser no nula — medir el coste del backfill en I/O y tiempo ayuda a decidir la ventana de migración.
Compactación, small files y gestión de costes
Un denominador común en canalizaciones CDC es la aparición de muchos ficheros pequeños (small files), lo que degrada tanto el rendimiento de las consultas como incrementa costes de I/O. La estrategia es escribir en batches controlados y/o activar técnicas de coalescing y compaction periódicas. En el contexto Delta, ejecutar operaciones de OPTIMIZE/compact (o usar el mecanismo de optimise de Fabric cuando aplicable) reduce ficheros y mejora el tiempo de lectura.
Se recomienda un umbral de ficheros: idealmente ficheros Parquet entre 128 MB y 512 MB para consultas analíticas. Para cargas de trabajo de streaming, agrupar eventos por intervalos de tiempo (p. ej.: 1–5 minutos) y forzar compaction nocturna puede equilibrar latencia y costes. Por ejemplo, escribir en micro-batches de 2 minutos con coalesce para ficheros de ~256 MB y ejecutar compaction profunda una vez al día suele reducir la latencia de lectura en 30–70%.
No olvide políticas de retención y VACUUM controlado para limpiar ficheros obsoletos sin comprometer transacciones pendientes. En entornos que retienen versiones por cumplimiento, planifiquen espacio adicional: mantener 7–14 días de versiones puede aumentar el almacenamiento en un 10–30%, dependiendo de la tasa de cambio.
Observabilidad, pruebas y SLAs para canalizaciones CDC
Sin métricas y pruebas automatizadas, una canalización CDC es una caja negra. Instrumente cada etapa: contadores de eventos leídos, latencia end-to-end (P50/P95/P99), tasa de error, contadores de duplicados y tamaño/cantidad de ficheros. Logs estructurados y métricas exportadas a un sistema de monitorización (Application Insights, Log Analytics o Grafana) permiten crear alertas por umbrales de retraso (por ej., lag > 5 min) o error continuo.
Métricas concretas a seguir (ejemplos): throughput medio y pico (events/sec), lag P95 < 5 minutos, tasa de duplicados < 0.05%, reconciliación diaria con divergencia < 0.02%. Las alertas activas deben incluir notificación a operaciones cuando el lag excede los SLA, cuando el número de ficheros pequeños sube 3x en 24 horas, o cuando la tasa de errores por minuto supera un umbral (p. ej.: > 10/min).
La verificación de integridad debe incluir pruebas de contract, pruebas de regresión de esquema y comparaciones de checksums entre origen y destino. Automatice pruebas con pipelines CI que validen merges, ejecuciones de streaming en sandbox y escenarios de fallo — por ejemplo: reinicio del consumidor, duplicación de eventos y cambio de esquema en entorno de staging. Los procedimientos de reconciliación pueden ser simples: comparar contajes por hora y sumas de campos críticos (p. ej.: total_sales) y recalcular checksums por pk; la tolerancia de discrepancia puede definirse según la criticidad del dato.
Mini-caso práctico: implementación CDC en una empresa de 80 empleados
En una empresa de 80 personas con una plataforma de e-commerce, la base de datos transaccional contiene 10 millones de registros de clientes y crece en 100k eventos/día. El objetivo: reducir la latencia de actualización del inventario y del dashboard de ventas de 24 horas a menos de 5 minutos, manteniendo un coste operacional moderado.
Solución implementada: activar CDC en el SQL Server (fuente), usar Debezium para extraer cambios a Azure Event Hubs, y un job Spark Structured Streaming en Fabric que consuma eventos y escriba en tablas Delta en la Lakehouse. Implementaron también un schema registry y métricas en Log Analytics. Detalles y resultados tras 3 meses:
- Tasa media de eventos: 2.5k events/sec; pico 7k/s durante promociones.
- Latencia media end-to-end: 3,8 minutos (objetivo <5 min alcanzado). P95: 7,2 minutos en picos.
- Refresh de los informes operativos en Power BI reducido de 45 minutos a 6 minutos.
- Costes incrementales de computación: aumento de ~18% en el coste mensual, principalmente por clusters reservados para streaming; este coste se compensó con una reducción del 22% en pérdidas de stock y una mejora del 4% en la conversión durante campañas.
- Operación: compaction nocturna redujo ficheros pequeños en 85% y disminuyó I/O en 40%; la reconciliación diaria indicó concordancia del 99.98% entre origen y Lakehouse.
Este mini-caso ilustra que, incluso en equipos pequeños, con elecciones pragmáticas (CDC nativo, Debezium, Event Hubs y Spark en Fabric) se consigue un salto cualitativo en el tiempo de respuesta del negocio sin un aumento exponencial de costes. La clave fue invertir en los primeros 2–4 sprints en observabilidad y pruebas automáticas — esto redujo incidentes en producción en un 70% en el segundo trimestre.
Una canalización CDC saludable no es la que transmite más eventos por segundo — es la que entrega datos correctos, en el momento adecuado y de forma predecible.
Checklist práctica para implementar CDC en Microsoft Fabric
Antes de arrancar, confirme estos puntos con su equipo técnico y de producto:
- Fuente con CDC nativo o adaptadores (Debezium/CDC connector) y esquema de claves estable.
- Decisión de transporte: Kafka/Event Hubs para streaming, o canalizaciones micro-batch para ingestión incremental.
- Diseño de mensajes con campo de secuencia/LSN y timestamp de cambio; incluir is_tombstone para deletes.
- Mecanismo de escritura idempotente (Delta MERGE por clave + condición de secuencia).
- Políticas de evolución de esquema (schema registry o versión controlada) y pruebas automatizadas.
- Rutinas de compaction y políticas de retención definidas para minimizar ficheros pequeños y costes.
- Métricas y alertas configuradas: lag, throughput, error, ficheros y reconciliación diaria.
En resumen
- Elija streaming cuando necesite latencia subminuto; opte por micro-batch cuando la latencia permita simplicidad y menor coste.
- Diseñe idempotencia con clave + secuencia/LSN; use merges condicionales para evitar regresiones por reordenación.
- Planifique la evolución de esquema con schema registry y migraciones controladas; evite renombramientos directos.
- Mitigue los small files con compaction y umbrales de fichero; optimice para ficheros Parquet de 128–512 MB.
- Automatice observabilidad, pruebas y reconciliación para mantener SLA operativos fiables.
Conclusión y próximos pasos
Implementar CDC en Microsoft Fabric es una combinación de buenas prácticas arquitecturales y disciplina operacional. Las decisiones — transporte, estrategia de ingestión, gestión de esquema y políticas de compactación — influyen directamente en la calidad de los datos consumidos por Power BI y modelos de IA. Para equipos que empiezan, el camino pragmático es probar un flujo mínimo viable: activar CDC en el origen, mover eventos a un tópico en Event Hubs, y validar una canalización de micro-batch o streaming simple que escriba en Delta con operaciones de merge idempotentes.
Los próximos pasos recomendados son: 1) crear un prototipo en staging con un subconjunto de datos críticos; 2) implementar métricas básicas y alertas; 3) automatizar pruebas de contract y reconciliación; 4) validar costes con cargas de trabajo representativas. Estas etapas reducen riesgo y permiten iterar rápidamente en una plataforma robusta.
¿Quiere debatir un caso concreto de su organización o validar un diseño arquitectural para su canalización CDC en Microsoft Fabric?