Dados mutam a cada segundo — o valor está em captar essa mutação de forma fiável e acionável.
Porque o CDC importa nas arquitecturas Lakehouse
Change Data Capture (CDC) deixou de ser uma técnica de bastidor para se tornar peça central das plataformas analíticas modernas. Numa era em que decisões operacionais e relatórios estratégicos exigem frescura de dados, passar de cargas batch diárias para captura de alterações em tempo quase real transforma processos: detecção de fraude, actualização de inventário, métricas de experiência do utilizador e relatórios financeiros com latência reduzida.
No contexto do Microsoft Fabric, onde a Lakehouse e o OneLake funcionam como fonte única de verdade para BI e IA, integrar CDC correctamente garante que os modelos de dados no Power BI e as pipelines de Machine Learning tenham inputs consistentes. O desafio não é apenas mover eventos; é preservar ordem, garantir idempotência, gerir evolução de esquema e minimizar custos operacionais — tudo isso sem sacrificar SLAs de latência e integridade.
Além dos benefícios óbvios de frescura de dados, um pipeline CDC bem desenhado reduz custos indiretos: menos retrabalhos em relatórios, menos consultas de reconciliação manual e decisões de negócio tomadas com confiança. Em organizações medianas, consegue-se frequentemente reduzir ciclos de decisão de horas para minutos e cortar em 10–30% o esforço humano associado a correcções de dados.
Escolhas de ingestão: streaming vs micro-batch no Fabric
A primeira decisão prática é o padrão de ingestão. O micro-batch (por exemplo, queries incrementais via Azure Data Factory/Power Query numa cadência de 1–5 minutos) é simples de implementar e suficiente para muitos cenários analíticos com latência tolerante. Em contraste, streaming (Debezium/Kafka/Event Hubs → Spark Structured Streaming no Fabric) é indicado quando se exige latência sub-minuto e processamento por evento — por exemplo, meios de pagamento, detecção de anomalias em tempo real ou actualização instantânea de inventário durante campanhas.
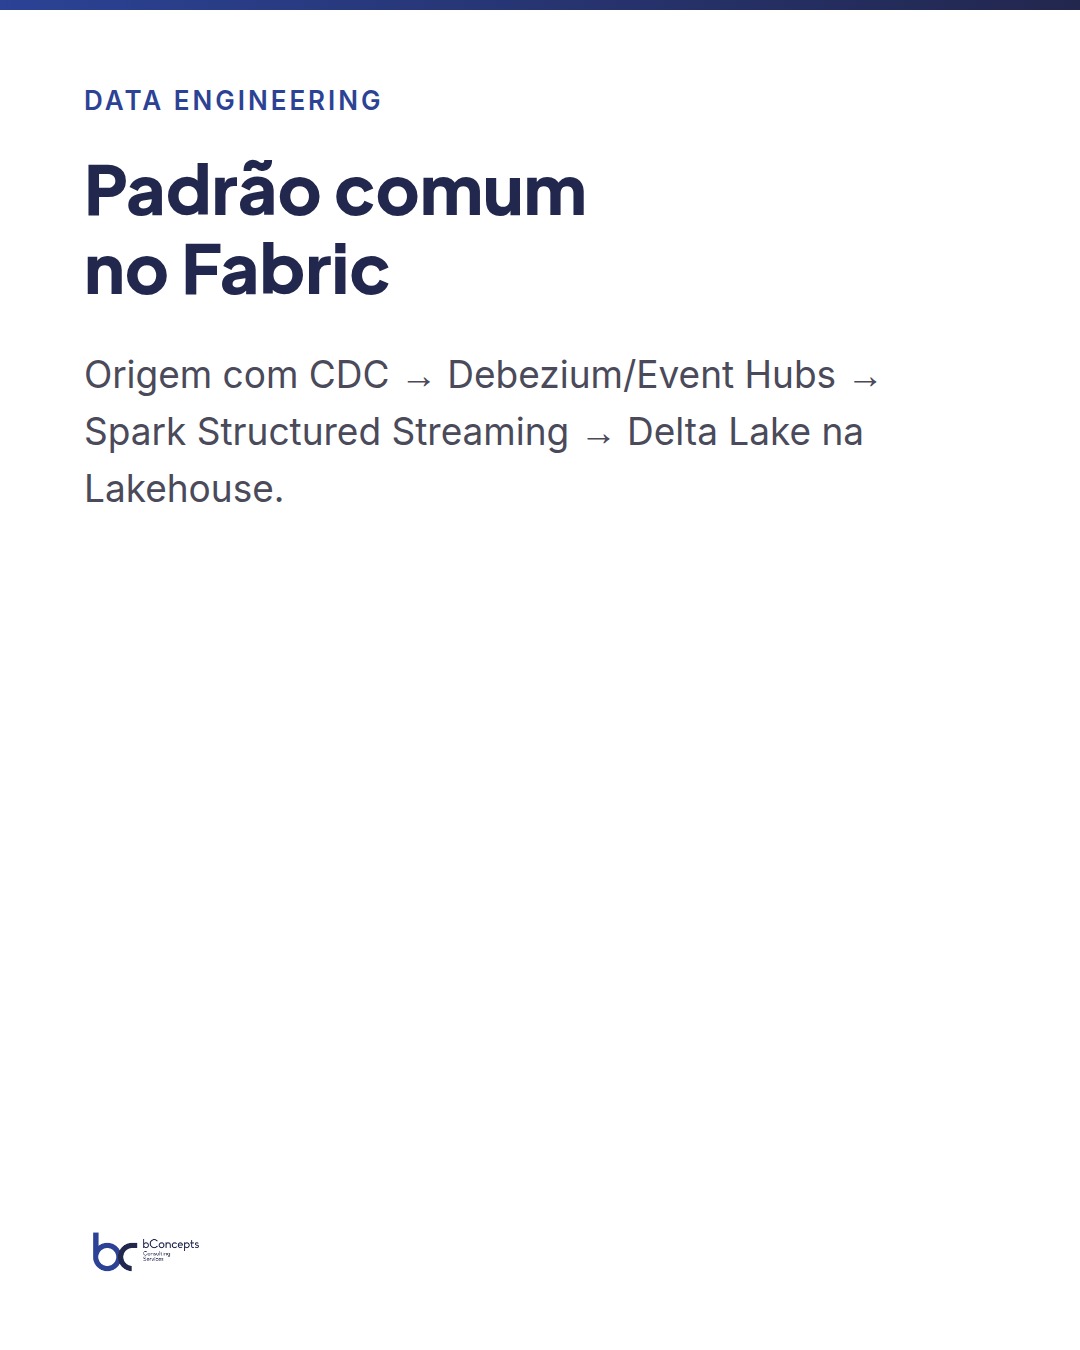
No Fabric, um padrão comum é: origem com suporte CDC (SQL Server, PostgreSQL, Cosmos DB), produtor CDC (Debezium ou protocolo nativo), transporte (Apache Kafka ou Azure Event Hubs) e consumidor Spark Structured Streaming a escrever para Delta Lake na Lakehouse. Para cenários mais simples, pipelines de micro-batch com watermarking e queries incrementais reduzem complexidade e custos e ainda conseguem latências na ordem dos 1–5 minutos.
Algumas regras práticas para decidir: se o negócio exige latência média abaixo de 1 minuto e picos previsíveis até dezenas de milhares de eventos por segundo, opte por streaming. Se a latência aceitável é 1–15 minutos e a equipa prefere simplicidade operacional, o micro-batch é frequentemente a escolha correcta. Também existe um ponto intermédio: micro-batches de 30–60 segundos que oferecem uma boa relação entre latência e custo operacional.
Idempotência, ordenação e resolução de conflitos
Num mundo de retries, duplicados e latência variável, desenhar pipelines idempotentes é obrigatório. Estratégias práticas incluem a utilização de chaves naturais ou surrogate keys, um campo de sequência/LSN (Log Sequence Number) e um timestamp de alteração. Ao escrever para tabelas Delta, o padrão "merge by key using sequence" permite aplicar apenas a alteração mais recente, descartando duplicados ou reordenações.
Um esquema comum de evento CDC contém: pk, op_type (I/U/D), change_ts, lsn, payload e possivelmente um campo is_tombstone. O consumidor executa um MERGE por pk com condição de actualização apenas quando lsn ou change_ts for maior do que o actualmente persistido. Exemplo lógico de condição: WHEN MATCHED AND incoming.lsn > target.lsn THEN UPDATE SET ...
Para gerir reordenações, mantenha janelas de tolerância (por exemplo, 15 minutos) durante as quais eventos tardios são aceites para actualizar registos, e registos que chegam fora dessa janela vão para uma tabela de "late arrivals" para reconciliação manual ou automática. Em sistemas com tolerância zero a inconsistências temporais — por exemplo, contagem de inventário sincronizada com POS — considerem mecanismos adicionais como confirmação de leitura no produtor ou versões por transacção.
Tratamento de deletes merece atenção: não presuma que um delete na origem significa eliminar imediatamente o registo na Lakehouse. Em vez disso, use tombstones (is_deleted=TRUE, change_ts) e políticas de retenção/expurgo, o que permite auditar e reconciliar antes de efectuar um VACUUM definitivo.
Gerir evolução de esquema em pipelines CDC
Evolução de esquema é a principal fonte de rupturas em pipelines CDC. Adição de colunas, alteração de tipos ou renomeação de campos podem quebrar consumidores a montante e relatórios a jusante. Existem duas grandes tácticas: permissiva e explícita. A permissiva usa formatos auto-descritivos (AVRO/JSON com schema registry) e operações de escrita que suportam schema-on-read/merge; a explícita introduz versões de esquema e contratos claros entre product owners e equipas de dados.
Práticas concretas que reduzem risco: 1) obrigar compatibilidade de schema no registry (backwards/forwards/fully compatible conforme o caso); 2) usar novos campos como opcionais e com valores por omissão; 3) evitar renomeações directas — em vez disso, introduza a nova coluna simultaneamente à antiga e planeie a remoção após um período de coexistência (por exemplo, 90 dias).
No Fabric, empregar um schema registry (Confluent ou Azure Schema Registry) e garantir que a escrita para Delta envolva schema merging controlado é pragmático. Para testes, automatizem cenários em staging: mudar tipo de coluna para integer->bigint, adicionar arrays/structs, e validar consumidores. Sempre incluam backfills quando uma coluna passa a ser não nula — medir o custo de backfill em I/O e tempo ajuda a decidir janela de migração.
Compactação, small files e gestão de custos
Um denominador comum em pipelines CDC é o aparecimento de muitos ficheiros pequenos (small files), o que degrada tanto a performance das queries como aumenta custos de I/O. A estratégia é escrever em batches controlados e/ou activar técnicas de coalescing e compaction periódicas. No contexto Delta, executar operações de OPTIMIZE/compact (ou usar o mecanismo de optimise do Fabric quando aplicável) reduz ficheiros e melhora o tempo de leitura.
Recomenda-se um threshold de ficheiros: idealmente ficheiros Parquet entre 128 MB e 512 MB para queries analíticas. Para workloads de streaming, agrupar eventos por intervalos de tempo (ex.: 1–5 minutos) e forçar compaction nocturna pode equilibrar latência e custos. Por exemplo, escrever em micro-batches de 2 minutos com coalesce para ficheiros de ~256 MB e executar compaction profunda uma vez por dia costuma reduzir latência de leitura em 30–70%.
Não esquecer políticas de retenção e VACUUM controlado para limpar ficheiros obsoletos sem comprometer transacções pendentes. Em ambientes que retêm versões por conformidade, planeiem espaço adicional: manter 7–14 dias de versões pode aumentar o armazenamento em 10–30%, dependendo da taxa de mudança.
Observabilidade, testes e SLAs para pipelines CDC
Sem métricas e testes automatizados, um pipeline CDC é uma caixa negra. Instrumente cada etapa: contadores de eventos lidos, latência end-to-end (P50/P95/P99), taxa de erro, contadores de duplicados e tamanho/contagem de ficheiros. Logs estruturados e métricas exportadas para um sistema de monitorização (Application Insights, Log Analytics ou Grafana) permitem criar alertas por thresholds de atraso (por ex., lag > 5 min) ou erro contínuo.
Métricas concretas a acompanhar (exemplos): throughput médio e pico (events/sec), lag P95 < 5 minutos, taxa de duplicados < 0.05%, reconciliação diária com divergência < 0.02%. Alertas activos devem incluir notificação de operação quando lag excede SLAs, quando o número de ficheiros pequenos sobe 3x em 24 horas, ou quando a taxa de erros por minuto excede um limiar (ex.: > 10/min).
Verificação de integridade deve incluir testes de contract, testes de regressão de schema e comparações de checksums entre origem e destino. Automatize testes com pipelines CI que validem merges, execuções de streaming em sandbox e cenários de falha — por exemplo: reinício do consumidor, duplicação de eventos, e alteração de esquema em ambiente de staging. Procedimentos de reconciliação podem ser simples: comparar contagens por hora e somas de campos críticos (ex.: total_sales) e recalcular checksums por pk; tolerância de discrepância pode ser definida conforme criticidade do dado.
Mini-caso prático: implementação CDC numa empresa de 80 colaboradores
Numa empresa de 80 pessoas com uma plataforma de e-commerce, a base de dados transaccional contém 10 milhões de registos de clientes e cresce a 100k eventos/dia. O objectivo: reduzir latência de actualização do inventário e dashboard de vendas de 24 horas para menos de 5 minutos, mantendo custo operacional moderado.
Solução implementada: activar CDC no SQL Server (fonte), usar Debezium para extrair alterações para Azure Event Hubs, e um job Spark Structured Streaming no Fabric a consumir eventos e escrever para tabelas Delta na Lakehouse. Implementaram também um schema registry e métricas em Log Analytics. Detalhes e resultados após 3 meses:
- Taxa média de eventos: 2.5k events/sec; pico 7k/s durante promoções.
- Latência média end-to-end: 3,8 minutos (objectivo <5 min atingido). P95: 7,2 minutos em picos.
- Refresh dos relatórios operacionais no Power BI reduzido de 45 minutos para 6 minutos.
- Custos incrementais de computação: aumento de ~18% no custo mensal, principalmente por clusters reservados para streaming; este custo foi contrabalançado por 22% de redução nas perdas de stock e melhoria de 4% na conversão durante campanhas.
- Operação: compaction nocturna reduziu ficheiros pequenos em 85% e diminuiu I/O em 40%; reconciliação diária indicou concordância de 99.98% entre origem e Lakehouse.
Este mini-caso ilustra que, mesmo em equipas pequenas, com escolhas pragmáticas (CDC nativo, Debezium, Event Hubs e Spark no Fabric) se consegue um salto qualitativo no tempo de resposta do negócio sem um aumento exponencial dos custos. A chave foi investirem nos primeiros 2–4 sprints em observabilidade e testes automáticos — isso reduziu incidentes em produção em 70% no segundo trimestre.
Um pipeline CDC saudável não é o que transmite mais eventos por segundo — é o que entrega dados correctos, no tempo certo e de forma previsível.
Checklist prática para implementar CDC no Microsoft Fabric
Antes de arrancar, confirme estes pontos com a sua equipa técnica e de produto:
- Fonte com CDC nativo ou adaptadores (Debezium/CDC connector) e esquema de chaves estável.
- Decisão de transporte: Kafka/Event Hubs para streaming, ou pipelines micro-batch para ingestão incremental.
- Design de mensagens com campo de sequência/LSN e timestamp de alteração; incluir is_tombstone para deletes.
- Mecanismo de escrita idempotente (Delta MERGE por chave + condição de sequência).
- Políticas de evolução de esquema (schema registry ou versão controlada) e testes automatizados.
- Rotinas de compaction e políticas de retenção definidas para minimizar ficheiros pequenos e custos.
- Métricas e alertas configurados: lag, throughput, erro, ficheiros, e reconciliação diária.
Em resumo
- Escolha streaming quando necessitar de latência sub-minuto; opte por micro-batch quando a latência permitir simplicidade e custo mais baixo.
- Projete idempotência com chave + sequência/LSN; use merges condicionais para evitar regressões por reordenação.
- Planeie evolução de esquema com schema registry e migrações controladas; evite renomeações directas.
- Mitigue small files com compaction e thresholds de ficheiro; optimize para ficheiros Parquet de 128–512 MB.
- Automatize observabilidade, testes e reconciliação para manter SLAs operacionais fiáveis.
Conclusão e próximos passos
Implementar CDC no Microsoft Fabric é uma combinação de boas práticas arquitecturais e disciplina operacional. As decisões — transporte, estratégia de ingestão, gestão de esquema e políticas de compactação — influenciam directamente a qualidade dos dados consumidos por Power BI e modelos de IA. Para equipas que começam, o caminho pragmático é provar um fluxo mínimo viável: activar CDC na origem, mover eventos para um tópico em Event Hubs, e validar um pipeline de micro-batch ou streaming simples que escreva para Delta com operações de merge idempotentes.
Os próximos passos recomendados são: 1) criar um protótipo em staging com um subconjunto de dados críticos; 2) implementar métricas básicas e alertas; 3) automatizar testes de contract e reconciliação; 4) validar custos com workloads representativos. Estas etapas reduzem risco e permitem iterar rapidamente numa plataforma robusta.
Quer debater um caso concreto da sua organização ou validar um desenho arquitectural para o seu pipeline CDC no Microsoft Fabric?