Los datos sintéticos bien diseñados son el puente entre regulación, escasez y modelos que funcionan en producción.
Por qué usar datos sintéticos en el pipeline de IA
La verdad incómoda en las implementaciones de Machine Learning es simple: no siempre existen datos suficientes, equilibrados y legales para entrenar modelos robustos. Ya sea por cuestiones de privacidad, por clases raras como fraude, churn o defectos, o por costes elevados de recogida y etiquetado, los proyectos tropiezan cuando el volumen o la representatividad de los datos fallan.
Los datos sintéticos ofrecen una respuesta práctica y medible. Al crear observaciones que preservan distribuciones marginales, dependencias multivariadas y patrones estacionales, es posible reducir sesgos, aumentar la sensibilidad a grupos minoritarios y acelerar ciclos de desarrollo. En términos prácticos: en lugar de esperar 12 meses más de recopilación de casos raros, se puede generar, validar e incorporar de 100k a 500k ejemplos sintéticos en pocas semanas, dependiendo de la complejidad.
Importa subrayar que los sintéticos no son una panacea. Su utilidad depende de la calidad del modelo generador, del rigor de las pruebas y de la adherencia a reglas de privacidad. Utilizados correctamente, permiten un trade-off favorable entre reducción de costes operativos —por ejemplo, menos horas de etiquetado manual y menor necesidad de recoger datos sensibles— y mejora del rendimiento de los modelos en producción.
Tipos de datos sintéticos y técnicas aplicables
No todos los datos sintéticos son iguales. La elección de la técnica correcta depende del tipo de datos y de los patrones que sea necesario preservar. Aquí están las familias principales y cuándo usarlas.
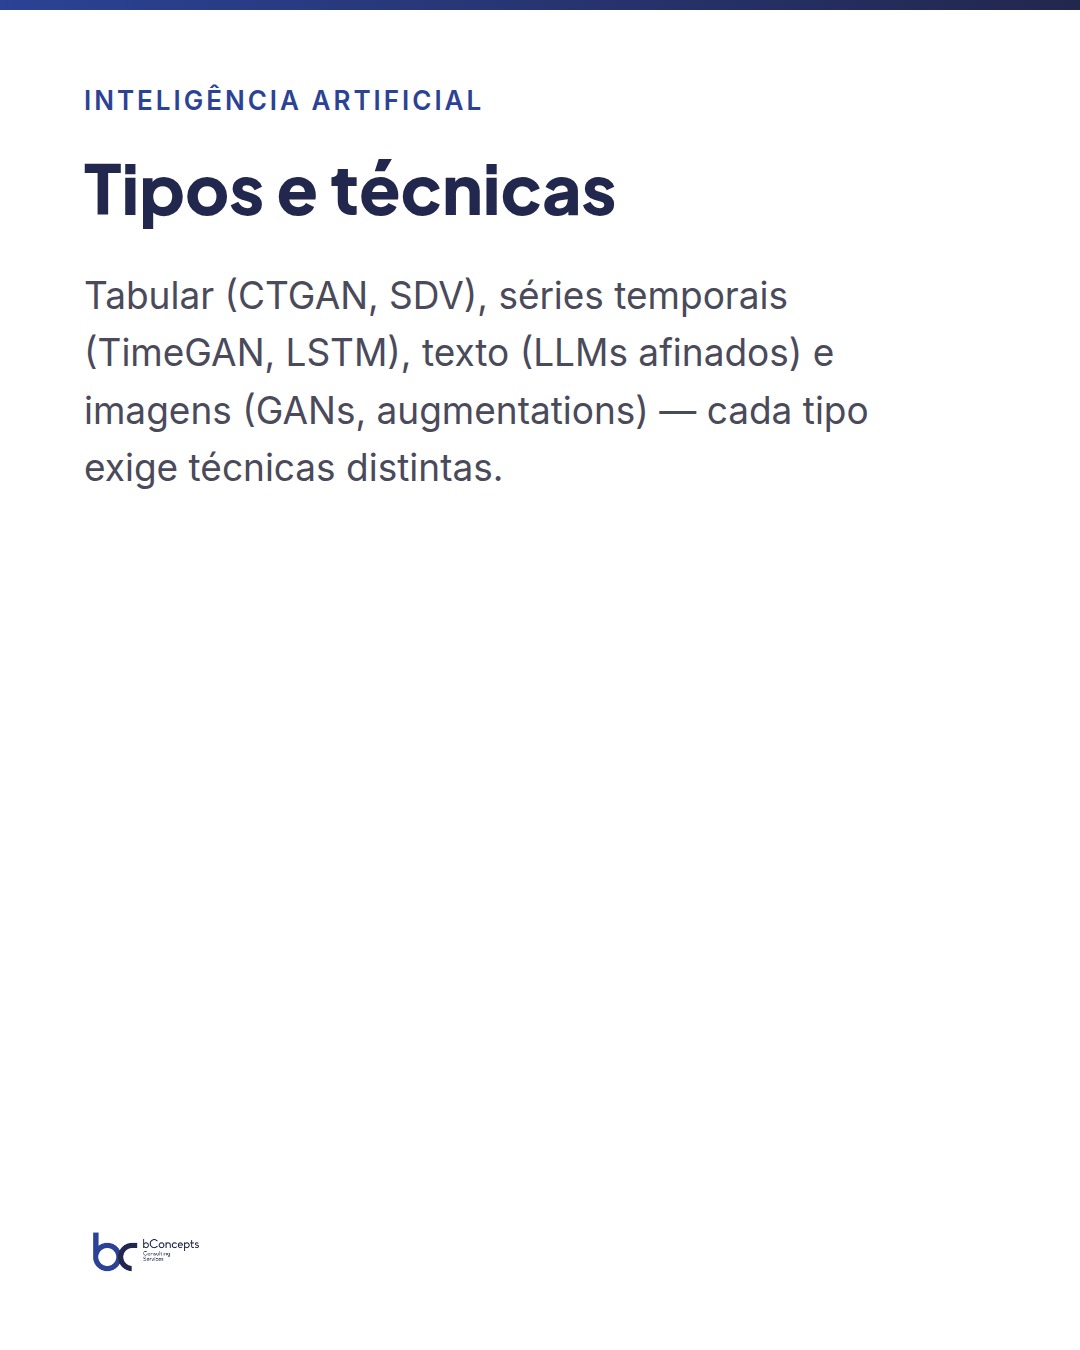
- Tabular — datos con variables categóricas y continuas. Técnicas como CTGAN, Copulas y la biblioteca SDV son eficaces para preservar correlaciones multivariadas y relaciones condicionales. En casos prácticos, CTGAN consigue generar decenas de miles de registros en minutos en un cluster Spark, manteniendo marginales dentro de desviaciones del 5 al 10% en las variables críticas.
- Series temporales — secuencias con autocorrelación, estacionalidad y eventos puntuales. Modelos como TimeGAN, o enfoques basados en RNN/LSTM, consiguen reproducir patrones diarios y semanales; para aplicaciones de detección de anomalías, simular rupturas o ventanas de mantenimiento puede recuperar del 20 al 40% del rendimiento perdido por falta de ejemplos reales.
- Texto — registros libres, descripciones o comentarios. LLMs finos o generación controlada son útiles para crear variaciones sin reproducir extractos sensibles. Un ejemplo práctico: generar 50k descripciones de reclamaciones con diferentes estilos y términos corregidos reduce el overfitting de modelos de clasificación textual en alrededor de un 10% a 15%.
- Imágenes — visión por computador. GANs, augmentations avanzadas y simulación física permiten aumentar la diversidad de escenarios (iluminación, ángulo, oclusiones). En aplicaciones industriales, generar variantes de defectos aumenta la tasa de detección entre un 12% y un 25% sin aumentar inspecciones físicas.
En Microsoft Fabric, la generación puede orquestarse dentro de Notebooks Python/PySpark. Bibliotecas como SDV y CTGAN funcionan bien en Spark Pools para cargas mayores; para texto puede utilizar modelos transformer afinados en AzureML o APIs de LLM integradas, y para imágenes combinar pipelines de augmentations con almacenamiento en el Lakehouse.
Flujo práctico en Microsoft Fabric: de la generación a la validación
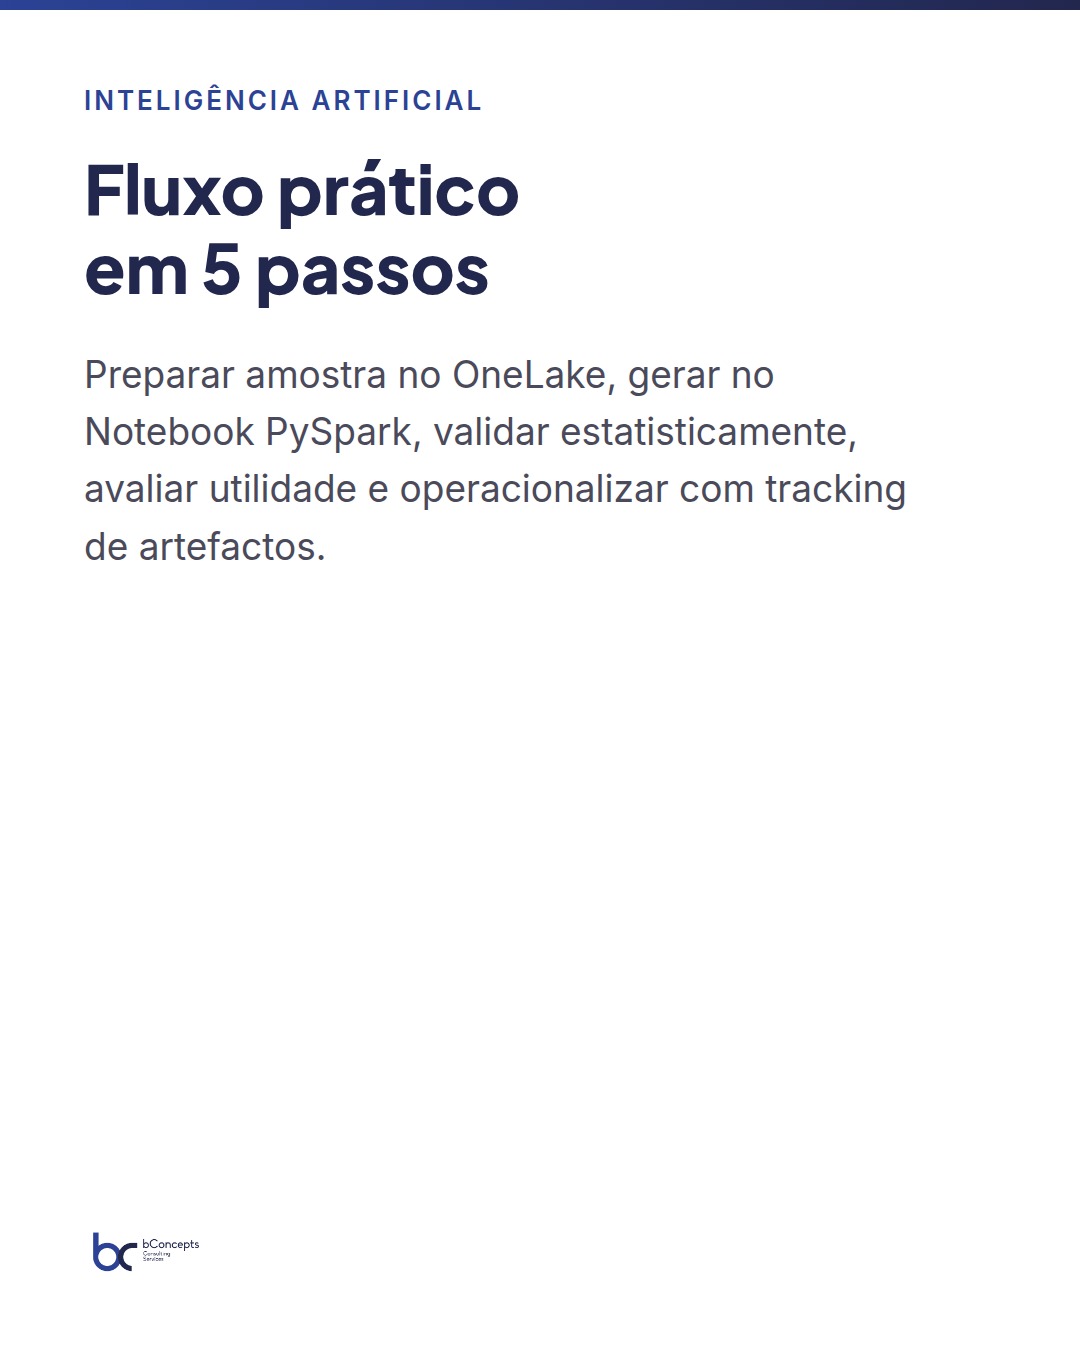
Un flujo operacional plausible en Fabric debe contemplar cinco etapas: preparación, generación, validación estadística, evaluación de utilidad y operacionalización. En términos técnicos, esto se traduce en pasos concretos y medibles:
- Preparar una muestra anonimizada en el Lakehouse (OneLake) y exportarla a un Notebook PySpark. Por ejemplo, extraer 50k registros estratificados por segmento para entrenar el generador.
- Generar datos sintéticos usando CTGAN/SDV para tablas, TimeGAN para series temporales o LLMs para texto; guardar versiones en el Lakehouse como tablas separadas con metadata detallada, incluyendo seed, versión del modelo y hash del fichero de origen.
- Ejecutar pruebas de calidad automatizadas: KS, Chi-square, comparación de matrices de correlación, análisis PCA y verificación de autocorrelaciones para series temporales. Documente los thresholds —por ejemplo, KS p valor mayor que 0.05 para variables continuas, divergencia de cópula por debajo de 0.2 para relaciones multivariadas.
- Evaluar utilidad mediante el entrenamiento de un modelo de referencia tanto en datos reales como en datos reales más sintéticos. Una práctica común es preparar tres escenarios: entrenamiento solo con datos reales, entrenamiento con real + 100k sintéticos y entrenamiento solo con sintéticos, y comparar AUC, F1 y recall por segmento.
- Registrar artefactos (conjuntos de datos, modelos, métricas) en el repositorio de artefactos del Fabric o en un sistema de tracking como MLflow, asegurando reproducibilidad. Mantenga una pipeline que valide cada lote automáticamente y marque el conjunto como aprobado para entrenamiento/producción cuando se satisfagan los criterios.
Con este flujo es posible automatizar experimentos donde, por ejemplo, se generan 100k ejemplos sintéticos por hora en un entorno controlado, ejecutar 50 pruebas estadísticas y obtener un informe consolidado en menos de 90 minutos, sin salir del ecosistema de datos corporativo.
Garantizar calidad y utilidad: métricas y pruebas esenciales
Generar muchos ejemplos no significa que sean útiles. La validación tiene dos dimensiones complementarias: fidelidad y utilidad. Fidelidad responde a la pregunta de si los sintéticos parecen reales; utilidad mide si mejoran el rendimiento del modelo en producción.
Las métricas prácticas y thresholds recomendados incluyen:
- Distribuciones marginales: utilizar KS-test para continuas y Chi-square para categóricas. Un umbral operativo típico es aceptar p valores que indiquen no rechazo de la hipótesis nula en el 95% de las variables críticas; aceptar desviaciones hasta 0.1-0.15 en indicadores de diferencia es a menudo razonable, dependiendo del caso de uso.
- Correlación y dependencia: comparar matrices de correlación con métricas como la norma de Frobenius y analizar divergencia de cópulas. Para muchas aplicaciones, preservar el 80-90% de la estructura de correlación entre variables explicativas es un objetivo práctico.
- Métricas de utilidad: entrenar el mismo modelo en escenarios de control. Ejemplo práctico: para un modelo de churn, añadir 150k registros sintéticos puede aumentar el recall del segmento vulnerable del 62% al 72% sin pérdida sustancial de precisión, evaluado en validación holdout.
- Propiedad de novedad: calcular distancia mínima entre registros sintéticos y reales en espacios de features o embeddings. Un umbral común es rechazar outputs con distancias por debajo de 0.01 en L2 normalizado, o cuando se detectan réplicas exactas.
Un proceso sano incluye reglas de pass/fail automáticas: por ejemplo, si el KS para una variable crítica excede 0.15, la generación entra en revisión; si el modelo pierde más del 2% de AUC cuando se entrena con sintéticos, el lote es rechazado y devuelto a la fase de calibración del generador.
Los datos sintéticos son útiles cuando se miden por su impacto: mejor generalización en el mundo real sin comprometer la privacidad ni introducir nuevos sesgos.
Riesgos prácticos y salvaguardas imprescindibles
Los datos sintéticos también pueden inducir errores si se usan mal. Riesgos frecuentes incluyen reproducción inadvertida de registros reales, amplificación de sesgos y exceso de confianza en patrones artificiales. Para mitigar, implemente salvaguardas técnicas y procedimentales bien definidas.
- Checks de anonimato: medir distancia entre muestras sintéticas y el conjunto de entrenamiento; rechazar outputs con distancia por debajo de un umbral. En entornos regulados, aplicar pruebas de duplicación que verifiquen si más del 0.01% de los registros sintéticos son idénticos a registros reales y bloquear la salida.
- Inyección de ruido diferencial: cuando la privacidad es crítica, aplicar mecanismos de Differential Privacy, como DP-SGD o adición calibrada de ruido Laplaciano a las distribuciones o a los pesos de los generadores. Esto reduce el riesgo de re-identificación, aunque con coste en fidelidad que debe cuantificarse.
- Auditoría de sesgos: comparar métricas por subgrupos protegidos y garantizar que los sintéticos no crean ganancias artificiales solo para subpoblaciones poco representadas. Por ejemplo, medir FPR y TPR por grupo demográfico antes y después de la inclusión de sintéticos.
- Gobernanza: registrar versiones de los modelos de generación, seeds, parámetros y políticas de aceptación; mantener trazas auditables para compliance. Documente decisiones como por qué un lote determinado fue aceptado y qué thresholds se usaron.
En la práctica, un buen pipeline rechaza automáticamente lotes de datos sintéticos que fallen checks de privacidad o que alteren significativamente métricas de fairness definidas por la organización. La combinación de pruebas automatizadas y revisiones periódicas por un equipo de auditoría garantiza equilibrio entre innovación y compliance.
Mini-caso práctico: minorista que redujo pérdidas por fraude
En una cadena nacional de retail con 120 empleados, el equipo de análisis gestionaba 3 millones de transacciones al año. El problema: las fraudes representaban solo el 0,25% de las transacciones, demasiado escasas para un clasificador robusto. El sistema en producción presentaba recall del 58% sobre fraudes, con una tasa de falsos positivos del 0,18%, lo que generaba costes elevados en investigaciones manuales.
El equipo, en colaboración con nosotros, implementó un pipeline en Microsoft Fabric para generar datos sintéticos condicionados a características de fraude, como combinaciones sospechosas de IP, valores de compra elevados, horarios atípicos y patrones de devolución. El proceso fue el siguiente:
- Extracción de 25k registros reales etiquetados y preparación de features en el Lakehouse.
- Entrenamiento de un CTGAN condicionado en 48 horas en un Spark Pool y generación de 200k ejemplos sintéticos a lo largo de 7 días.
- Validación automática: pruebas KS en las variables monetarias, divergencia de cópula en las relaciones entre hora del día y valor de la compra, y check de distancia mínima que rechazó el 0.03% de los ejemplos por ser demasiado próximos a registros reales.
- Entrenamiento y comparación: el clasificador final fue entrenado con real + 200k sintéticos y comparado con la baseline.
Resultados offline y en producción:
- Recall: subió al 75% (vs 58%), con F1-score aumentando de 0,45 a 0,62.
- La tasa de falsos positivos se mantuvo controlada en 0,20% tras ajuste de threshold y revisión humana reducida solo a los casos de mayor riesgo.
- Impacto financiero: reducción del 34% en las pérdidas por fraude detectado y 18% menos horas de investigación manual por mes.
En términos de costes, el incremento en computación en Fabric fue de alrededor del 12% debido al uso de Spark Pools para generación y validación automática, una inversión que se amortizó en el primer trimestre mediante los ahorros directos. Estos números ilustran que la combinación correcta de tecnología, validación y gobernanza crea valor medible y replicable.
Cómo integrar datos sintéticos con Power BI y flujos de producción
Generar y validar son pasos técnicos; la verdadera ventaja operacional aparece cuando los conjuntos de datos sintéticos se convierten en parte integrante del ciclo de vida del producto analítico. En Microsoft Fabric, las mejores prácticas incluyen:
- Guardar conjuntos de datos aprobados en el Lakehouse con etiquetas metadata detalladas: origen=synthetic, versión, fecha de generación, seed, modelo de generación e hiperparámetros usados.
- Consumir estos conjuntos en modelos entrenados en Notebooks y registrar modelos en el repositorio/MLOps del Fabric. Crear pipelines de scoring que usen el modelo final en producción, con gate de validación que impida el deploy si métricas de fairness o AUC caen por debajo de thresholds definidos.
- Exponer métricas y dashboards en Power BI: tasa de aprobación de lotes sintéticos, comparación de distribuciones entre real y sintético, impacto sobre métricas de negocio como pérdidas por fraude, CTR o churn evitado. Los dashboards deben incluir alertas automáticas cuando métricas excedan límites.
Un punto práctico es señalar en los informes qué insights derivan de modelos entrenados con sintéticos. Esta transparencia facilita la comunicación con stakeholders, por ejemplo mostrando que una nueva regla de segmentación fue viabilizada únicamente gracias al refuerzo sintético de ejemplos raros, y permitiendo decisiones informadas sobre riesgo y adopción.
En resumen
- Los datos sintéticos son una herramienta práctica para lidiar con escasez, privacidad y clases raras, cuando van acompañados de validación rigurosa y procesos de gobernanza.
- En un pipeline en Microsoft Fabric, combine generación en Notebooks/Spark con pruebas estadísticas y métricas de utilidad para automatizar la aprobación de lotes y asegurar reproducibilidad.
- Implemente salvaguardas técnicas y procedimentales: checks de anonimato, differential privacy cuando sea necesario y auditoría de sesgos por subgrupos, con thresholds operativos claros.
- Integre con Power BI y procesos de MLOps para medir el impacto en el negocio y mantener transparencia sobre el uso de sintéticos.
Próximos pasos prácticos: identificar los casos de negocio que más se benefician (fraude, churn, defectos), prototipar una generación controlada con 25k a 200k ejemplos y establecer criterios automáticos de aceptación en Fabric. Si lo desea, podemos ayudar a montar ese primer pipeline, definir métricas de validación alineadas con sus KPIs y estimar costes y ganancias a tres trimestres.
¿Qué caso en su organización se beneficiaría más de una estrategia de datos sintéticos y qué recelos le gustaría ver mitigados primero?