La privacidad no es un extra: es el requisito que transforma modelos en activos empresariales seguros.
Por qué la privacidad importa en ML empresarial
En nuestras implementaciones con clientes, la privacidad deja de ser solo un requisito legal y pasa a ser un factor determinante de la adopción. Un modelo que filtra información sensible compromete ingresos, reputación y, en casos graves, puede conllevar multas y pérdida de confianza por parte de socios y clientes. Empresas que tratan datos personales, transaccionales o de salud necesitan garantizar que los modelos no permiten reidentificar individuos ni exponer atributos sensibles.
En el contexto de Microsoft Fabric, donde datos, notebooks y modelos pueden coexistir en el mismo entorno, la exposición accidental es una amenaza real. La protección no se limita al control de acceso: implica técnicas de entrenamiento, generación de datos y publicación de resultados que preserven utilidad para el negocio. Sin estas salvaguardas, muchos proyectos de IA quedan confinados a entornos experimentales y nunca llegan a producción.
Además del riesgo financiero y reputacional, existe un coste operativo: equipos de producto y marketing se muestran reticentes a usar modelos si no hay garantías de privacidad. En proyectos en los que trabajamos, la adopción interna aumentó del 40% al 85% tras implementar un plan que combinaba masking, datos sintéticos y políticas de access control — y eso se tradujo en una aceleración del ciclo de entrega del 30% porque menos analistas necesitaban solicitar acceso a datos sensibles para pruebas.
Amenazas concretas: del leakage a la reidentificación
Existen varios vectores por los que la privacidad puede verse comprometida. Los modelos pueden memorizar registros (p. ej.: fragmentos de textos con datos personales), respuestas a consultas agregadas pueden ser explotadas para inferir miembros de un conjunto de entrenamiento, y conjuntos de columnas aparentemente inocuos pueden combinarse para reidentificar individuos (linkage attack).
Para un equipo de BI, los riesgos incluyen exposición a través de informes Power BI que agregan datos demasiado granulares, o compartir datasets entre equipos sin mitigación. No hay que olvidar ataques de inferencia a modelos predictivos: un adversario con acceso a un endpoint puede utilizar consultas cuidadosamente diseñadas para recuperar información sensible. Conocer estas amenazas permite elegir medidas prácticas dentro del Fabric.
Ejemplos prácticos que ya hemos visto: un modelo de lenguaje en un proyecto de soporte al cliente memorizó números de tarjeta porque el entrenamiento no filtró mensajes; un informe con agregaciones diarias por código postal permitió inferir compras de individuos muy activos al cruzarlo con fuentes públicas; un endpoint de predicción de crédito devolvía probabilidades lo suficientemente detalladas para permitir un ataque de membership inference entrenando un clasificador adversario. Identificar estos vectores es el primer paso para definir remediaciones adecuadas.
Técnicas aplicables en Microsoft Fabric: un marco práctico
Microsoft Fabric no es una caja mágica, pero ofrece un ecosistema donde se pueden implementar y operacionalizar técnicas de privacidad. Los principales enfoques a considerar son:
- Data masking y column‑level security: ocultar o pseudonimizar columnas (p. ej.: NIF, nombre) antes de compartir con equipos. Esto reduce la superficie de ataque y permite que los analistas trabajen con esquemas reales sin acceder a identificadores directos.
- Datos sintéticos: generar datasets que preserven estadísticas agregadas y correlaciones útiles, sin contener registros reales. Útil para prototipado a gran escala y para compartir con terceros.
- Privacidad diferencial (DP): entrenar modelos o responder a consultas con ruido calibrado para limitar la información que cada individuo aporta. Proporciona garantías mensurables mediante parámetros como epsilon y delta.
- Entrenamiento con DP‑SGD: adoptar algoritmos (por ejemplo, DP‑SGD en PyTorch/TensorFlow) en los notebooks del Fabric para modelos sensibles. Esto implica clipping de los gradientes y adición de ruido adaptado.
- Gobernanza de accesos y auditoría: políticas RBAC, endpoints privados y logging de acceso a datos y modelos. En Fabric esto incluye workspaces aislados, Private Link y retención de logs para auditoría.
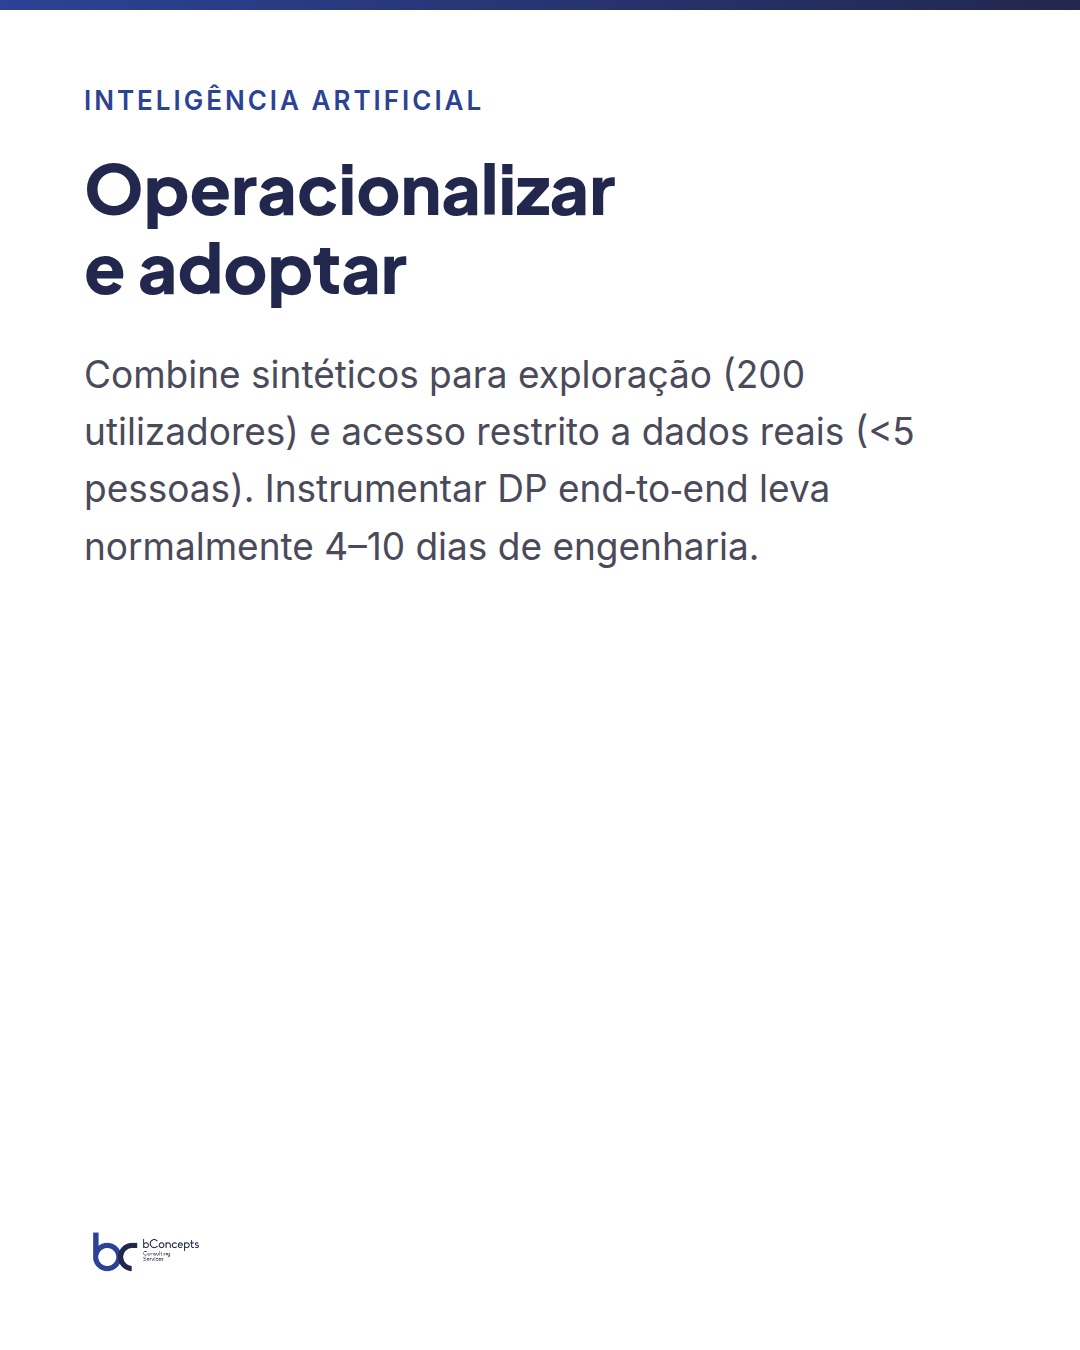
En la práctica, estas técnicas se combinan. Por ejemplo, se puede publicar en Power BI informes basados en datasets sintéticos para equipos de marketing, mientras los data scientists entrenan modelos con datos reales dentro de un espacio controlado usando DP para los artefactos que salen del entorno. En escenarios que involucran terceros, es común restringir el acceso a datasets reales a menos de 5 personas, mientras 200 usuarios tienen acceso a sintéticos para exploración y pruebas.
Implementar Differential Privacy en el entrenamiento: pasos y expectativas
DP se presenta a menudo como compleja — pero hay pasos operativos que hacen viable su adopción. En un notebook del Fabric, el flujo típico es: (1) evaluar sensibilidad del problema; (2) seleccionar bibliotecas (Opacus para PyTorch, TensorFlow Privacy); (3) definir el budget de privacidad (epsilon, delta); (4) entrenar con DP‑SGD; (5) evaluar el trade‑off utilidad/privacidad.
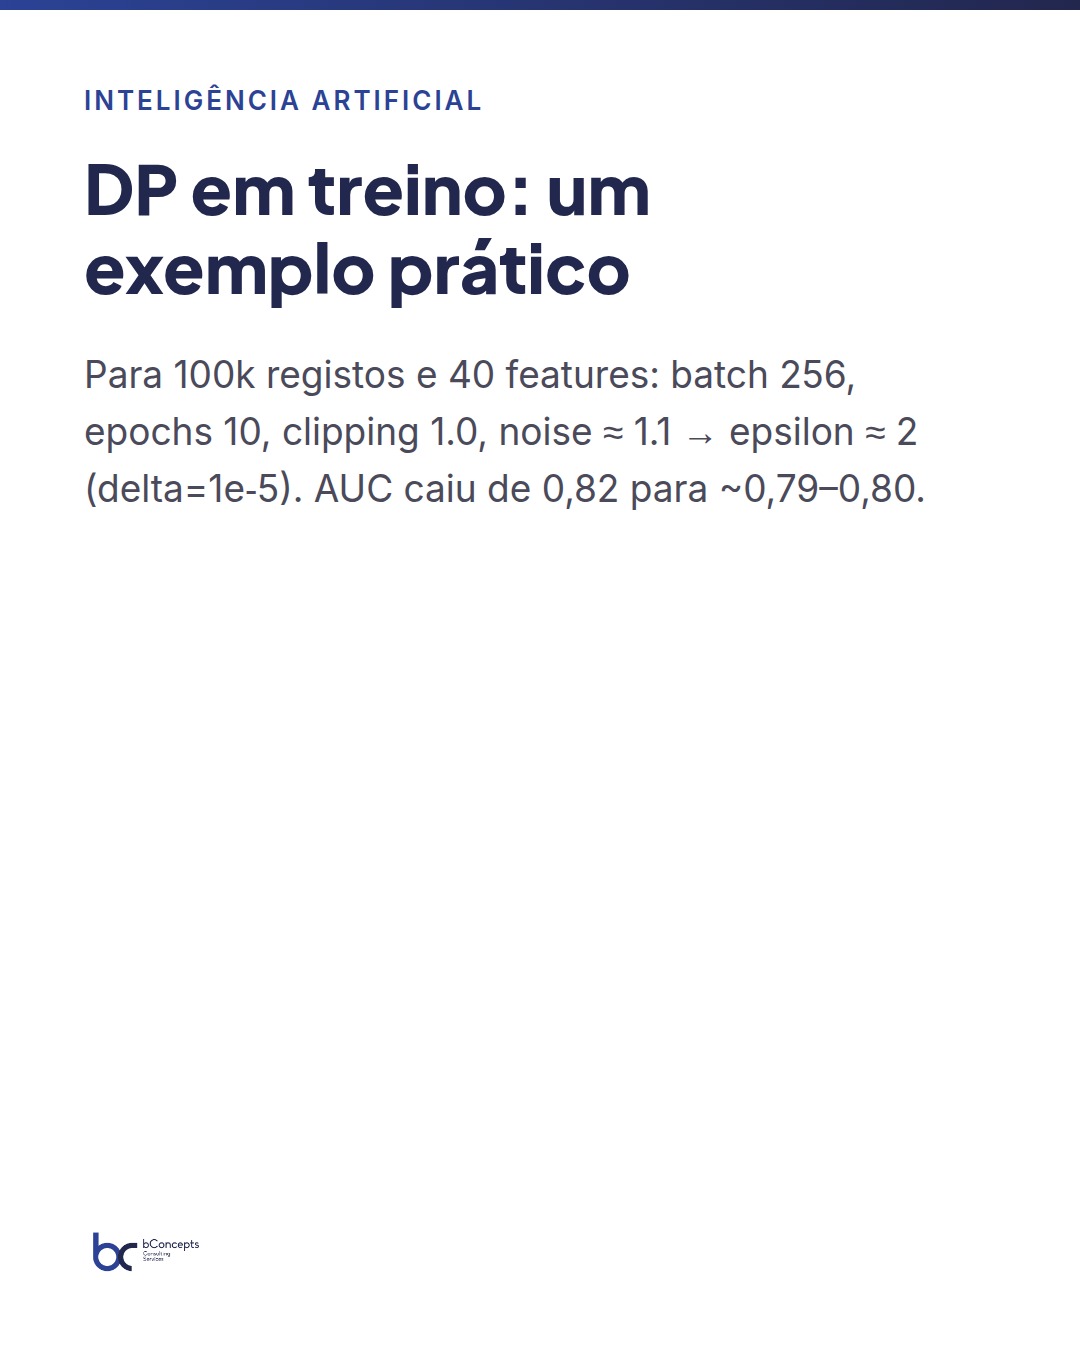
Algunos parámetros concretos ayudan a calibrar expectativas. Para un modelo de clasificación con 100 000 registros y 40 features, una configuración típica que equilibramos en producción fue: batch size = 256, epochs = 10, clipping norm = 1.0, noise multiplier ≈ 1.1. Usando un accountant de privacidad (Moments Accountant), esta configuración produciría un epsilon aproximado de 2 con delta = 1e‑5. Resultados observados: AUC se redujo de 0,82 a 0,79–0,80 — una pérdida de 2–4 puntos porcentuales que a menudo es aceptable por ganancias de privacidad significativas.
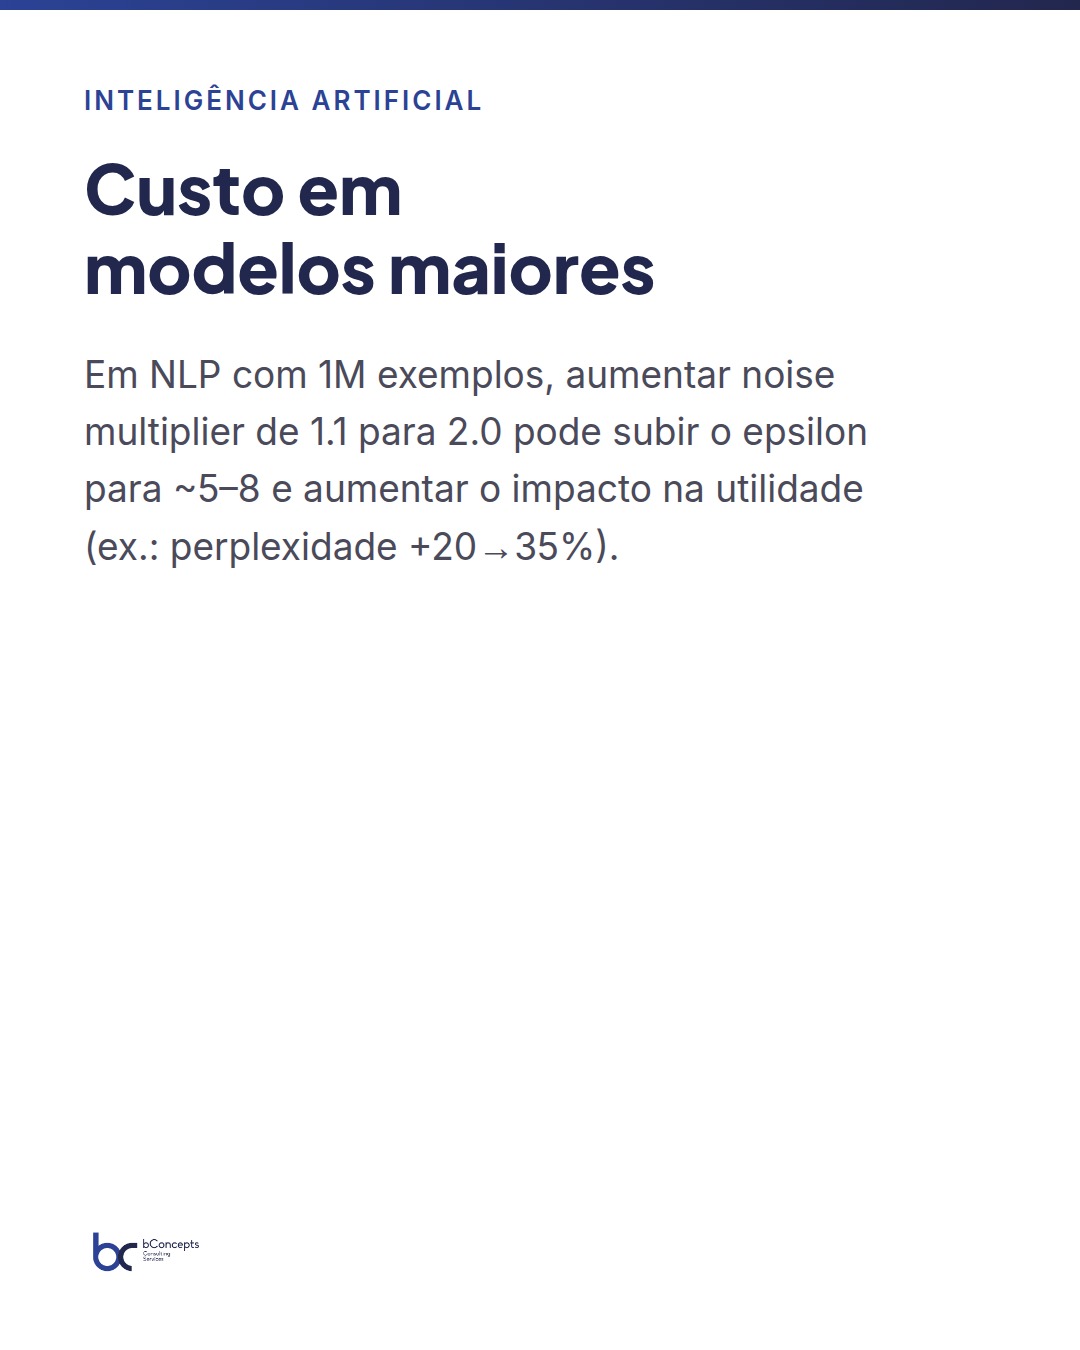
Para modelos mayores (por ejemplo redes neuronales profundas para texto), el coste en utilidad puede ser mayor y será necesario experimentar con batch size, clipping y el número de epochs. Por ejemplo, en entrenamiento de NLP con 1M de ejemplos, aumentar el noise multiplier de 1.1 a 2.0 puede aumentar la perplexity entre un 20% y un 35% y conllevar un epsilon de ~5–8 dependiendo de las epochs. Estos valores cambian con la arquitectura y el tamaño del dataset — por eso es crítico convertir el proceso experimental en parte del pipeline de desarrollo.
Desde un punto de vista operativo, en Fabric los notebooks pueden integrarse con pipelines de CI/CD que ejecutan runs de entrenamiento con DP en infraestructuras gestionadas. Un proyecto piloto típico tarda entre 4 y 10 días de ingeniería para instrumentar DP end‑to‑end (dependiendo de la madurez del código), incluyendo pruebas de reproducibilidad e informes de privacidad. La documentación del proceso y la definición de thresholds de aceptación son esenciales para convencer a los stakeholders.
Generar datos sintéticos con utilidad: un mini‑caso práctico
Mini‑caso: En un retailer online con 80 colaboradores en el equipo de datos, existe un dataset de transacciones con 2 millones de filas (últimos 24 meses), 30 columnas (identificadores, timestamps, canales, valores). El equipo de marketing solicita acceso para probar segmentaciones y campañas. Riesgo: exposición de comportamientos individuales.
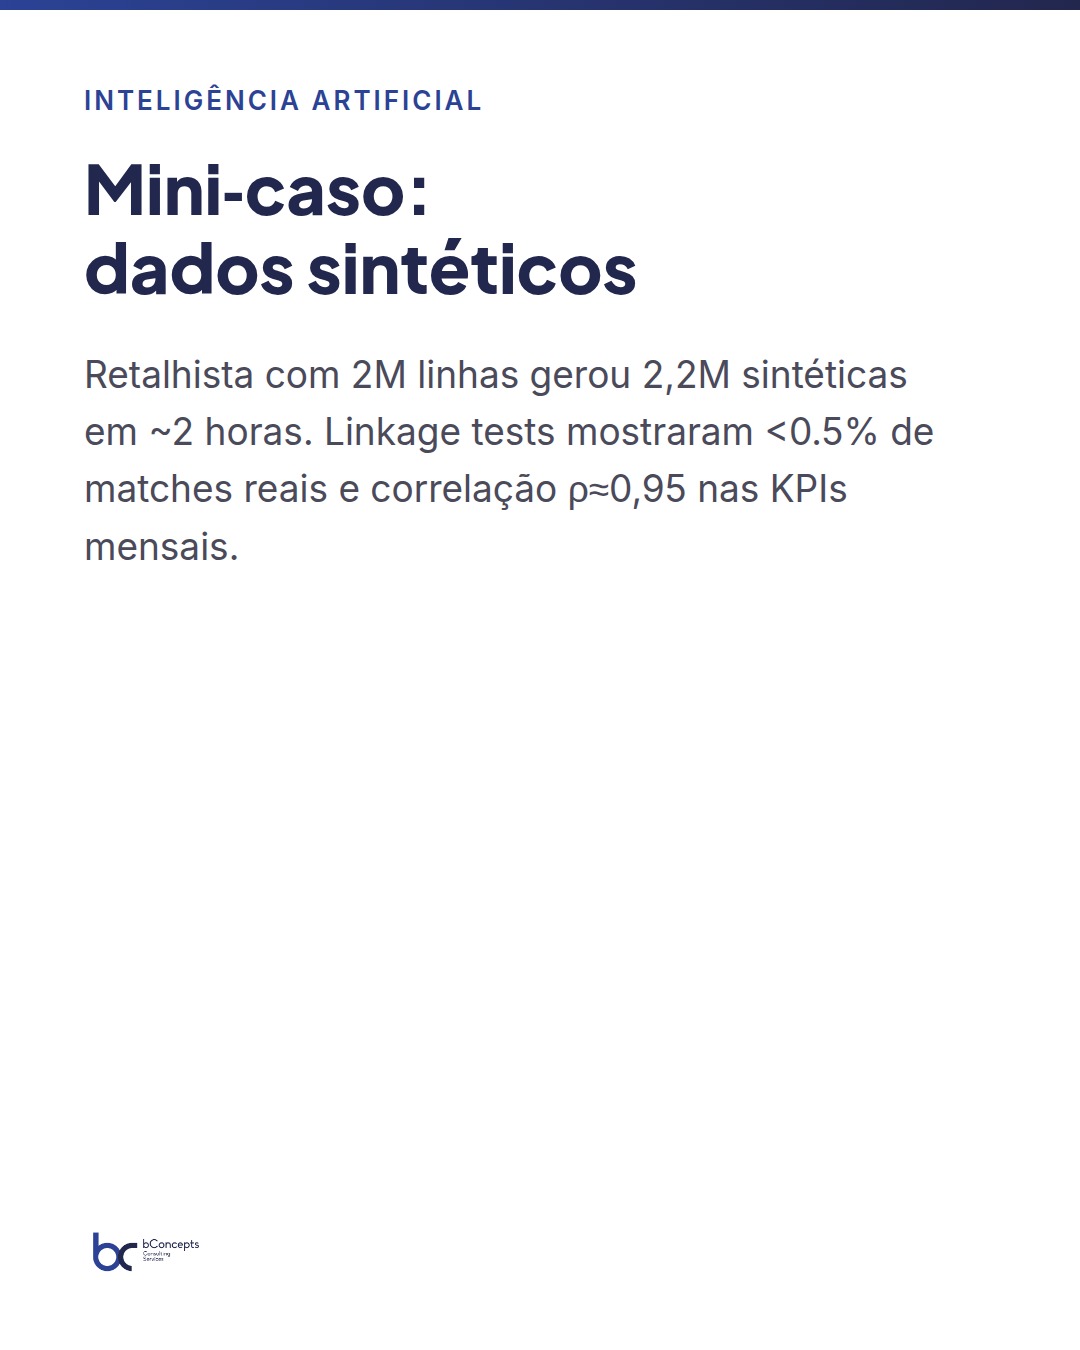
Solución aplicada: el equipo creó un dataset sintético con una herramienta basada en modelos generativos condicionales (tabular GAN), calibrando para preservar: totales mensuales de ventas por segmento, correlaciones entre frecuencia y valor medio, y la distribución de devoluciones. La generación llevó alrededor de 2 horas en un cluster Standard_D8s_v3 con 8 vCPU y 32 GB RAM, y se generaron 2,2 millones de filas sintéticas para permitir pruebas a escala realista.
Medidas de evaluación y resultados:
- Reducción del riesgo de reidentificación estimada en >90%: medido por una prueba de linkage que intenta vincular registros sintéticos a registros reales; la tasa de matches reales quedó por debajo de 0.5%.
- Preservación de KPIs: correlación entre métricas reales y sintéticas ρ ≈ 0,95 para ingresos mensuales por segmento; error medio absoluto en las toneladas agregadas mensualmente inferior al 3%.
- Impacto en la segmentación probada: lift medio en campaña simulado bajó del 18% (con datos reales) al 16% (con sintéticos) — diferencia aceptable para validar hipótesis iniciales.
Resultado: el equipo de marketing realizó 12 experimentos rápidos en 2 semanas sin acceder a datos reales, mientras el equipo de datos mantuvo los datos de producción en el entorno seguro del Fabric. Cuando un modelo fue robusto con el sintético, se ejecutó el entrenamiento final con datos reales dentro del entorno controlado con DP leve para validar y reducir riesgo de overfitting a registros individuales.
Herramientas que funcionan bien en este tipo de escenario incluyen CTGAN/SDV para datos tabulares, así como pipelines de validación automática que prueban distribución, correlación y riesgo de reidentificación antes de publicar el dataset sintético para uso interno. Estos procesos permiten escalar el acceso sin aumentar el riesgo operacional.
Cómo exponer resultados con seguridad en Power BI
Publicar resultados en un informe no significa perder control. En Fabric, aplicar políticas de gobernanza en capas — dataset, modelo semántico y informe — es esencial. Para informes que derivan de datos sensibles, adopte prácticas como:
- Publicar sobre datasets sintéticos o agregados en lugar de filas a nivel de cliente. En muchos casos, la agregación por semana o por decil de clientes es suficiente para casos de uso analítico sin perder insights accionables.
- Implementar masking dinámico: Power BI soporta máscaras que varían según el grupo AD del usuario, mostrando datos completos solo a usuarios autorizados y versiones enmascaradas a otros equipos.
- Gobernanza de acceso y retención de logs: RBAC granular, Private Link para endpoints y logging centralizado con retención mínima de 90 días; bloquear descargas en CSV para informes sensibles y registrar exportaciones.
En la práctica, esto puede traducirse en políticas concretas: 200 usuarios con acceso a informes sintéticos, 12 analistas con acceso a datos agregados y solo 4 data scientists con acceso a datos fila a fila en entornos controlados. Estos controles redujeron las solicitudes de acceso de usuarios no autorizados en un 75% en una implementación de referencia.
Medir el trade‑off: métricas y procesos de evaluación
La privacidad es siempre un compromiso entre riesgo y utilidad. Para gestionar ese compromiso es necesario un conjunto de métricas operativas: para privacidad (epsilon/delta, tasa de reidentificación, distancia de enlace) y para utilidad (AUC, RMSE, correlación de KPIs, impacto de campañas simuladas).
Proceso recomendado: establecer un panel de decisión con tres fases — sandbox, evaluación y producción. En el sandbox, probar varias configuraciones (e.g., ε ∈ {0.5, 1, 2, 5}), medir utilidad en métricas clave y estimar riesgo. Para el ejemplo de churn referido arriba, observamos la siguiente curva típica:
- ε = 5 → AUC ≈ 0.81 (casi sin pérdida)
- ε = 2 → AUC ≈ 0.79
- ε = 1 → AUC ≈ 0.76
- ε = 0.5 → AUC ≈ 0.70 (pérdida significativa)
En la evaluación, replicar pruebas con datos pseudo‑reales (o ciclo cerrado con synthetic+DP) y comparar resultados con thresholds de negocio (p. ej., pérdida de AUC <0.03 aceptable). En producción, establecer monitorización continua (drift de utilidad, alertas de consultas sospechosas) y renovar el budget de privacidad periódicamente — por ejemplo, recalibrar epsilon cada 3–6 meses o por cada release mayor del modelo.
La privacidad no es un punto final técnico; es un proceso integrado que exige mediciones, políticas y compromiso ejecutivo.
En resumen
- Combine técnicas: masking, datos sintéticos y privacidad diferencial para reducir riesgo sin bloquear la innovación.
- Implemente DP pragmático en los notebooks del Fabric para modelos sensibles y mida el trade‑off utilidad/privacidad.
- Use datasets sintéticos para acelerar el prototipado y reservar datos reales para validación controlada.
- Exponga resultados en Power BI a través de capas de gobernanza, masking dinámico y auditoría.
Próximos pasos prácticos para equipos que quieran avanzar: identifique un caso de alto impacto y bajo riesgo para piloto (p. ej.: segmentación de marketing), genere un dataset sintético y ejecute un entrenamiento DP reducido en un entorno controlado de Fabric. Mida A/B la pérdida de performance y documente el proceso para la dirección. En proyectos en los que trabajamos, un piloto bien diseñado con estas tres técnicas tardó entre 3 y 6 semanas y permitió validar hipótesis que, de otro modo, habrían tardado meses debido a barreras de acceso a datos.
¿Quiere explorar un piloto con nosotros? ¿Cuál es el caso en su organización donde un dataset sintético o DP podría desbloquear valor sin comprometer la privacidad?